بررسی وضعیت Nginx
در شروع عیبیابی Production، هدف این نیست که سریع سرویس را restart کنیم. ابتدا باید وضعیت فعلی process، workerها و مسیر configuration ثبت شود تا اگر مشکل intermittent است، شواهد از بین نرود.
sudo systemctl status nginx --no-pager
sudo nginx -V
ps aux | grep '[n]ginx'
ss -ltnp | grep nginx
بررسی syntax
قبل از reload، syntax را با همان binary و همان فایلهای include شده بررسی کنید. بسیاری از خطاهای Production از یک include اشتباه، مسیر certificate حذفشده، یا upstream تعریفنشده ایجاد میشوند.
sudo nginx -t
sudo nginx -T | less
بررسی access/error logs
برای تشخیص خطاهای واقعی، access log و error log را کنار هم ببینید. زمان خطا، upstream انتخابشده، status code، و مدت پاسخدهی backend مهم هستند.
sudo tail -n 120 /var/log/nginx/error.log
sudo tail -n 120 /var/log/nginx/access.log
sudo journalctl -u nginx --since "30 min ago" --no-pager
خطای 502 Bad Gateway
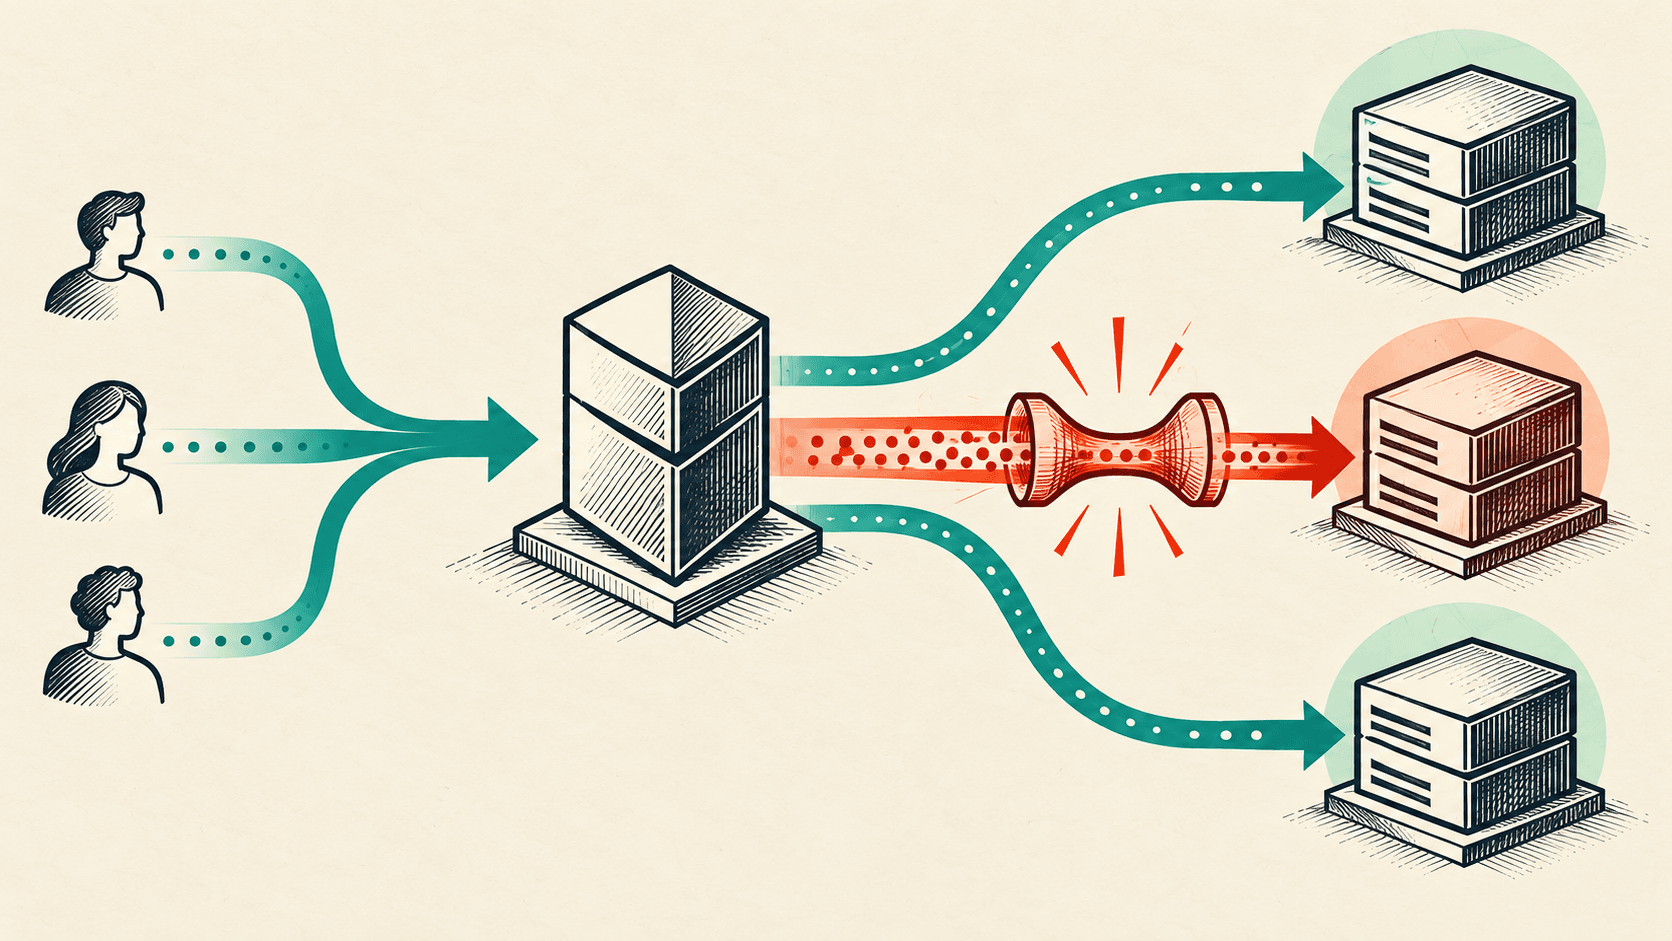
خطای 502 معمولا یعنی Nginx به upstream وصل شده یا تلاش کرده وصل شود، اما پاسخ معتبر نگرفته است. رایجترین علتها شامل down بودن backend، socket permission، mismatch در protocol، یا reset شدن اتصال توسط application است.
در زمان incident، پاک کردن log یا اجرای restartهای پشت سر هم میتواند علت اصلی را پنهان کند. ابتدا نمونه request، timestamp و پیام دقیق error log را ثبت کنید.
curl -I http://127.0.0.1:8080/health
sudo ss -ltnp | grep ':8080'
sudo journalctl -u app.service --since "15 min ago" --no-pager
خطای 504 Gateway Timeout
خطای 504 معمولا به کندی یا timeout در upstream مربوط است. در این حالت باید تفاوت بین connect_timeout، read_timeout و تاخیر واقعی application بررسی شود.
curl -w "@curl-format.txt" -o /dev/null -s http://127.0.0.1:8080/api/health
grep 'upstream timed out' /var/log/nginx/error.log | tail
بررسی upstream
اگر چند backend دارید، health هر node را جداگانه بررسی کنید. یک node ناسالم پشت load balancing میتواند خطا را فقط برای بخشی از کاربران ایجاد کند.
for port in 8080 8081 8082; do
  echo "checking $port"
  curl -fsS "http://127.0.0.1:${port}/health" || true
done
نمونه configuration
نمونه زیر یک reverse proxy ساده با headerهای ضروری، timeoutهای کنترلشده و upstream مشخص است. مقدارها باید با رفتار application و SLA واقعی تنظیم شوند.
upstream app_backend {
    server 127.0.0.1:8080 max_fails=3 fail_timeout=20s;
    keepalive 32;
}

server {
    listen 443 ssl http2;
    server_name example.com;

    access_log /var/log/nginx/app.access.log;
    error_log  /var/log/nginx/app.error.log warn;

    location / {
        proxy_pass http://app_backend;
        proxy_http_version 1.1;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_connect_timeout 5s;
        proxy_send_timeout 30s;
        proxy_read_timeout 30s;
    }
}چکلیست پایانی
- وضعیت
systemctlو processها ثبت شده است. - خروجی
nginx -tبدون خطا است. - error log با timestamp درخواستها بررسی شده است.
- سلامت upstreamها مستقل از Nginx تست شده است.
- timeoutها با رفتار application هماهنگ هستند.
- بعد از تغییر configuration، از
reloadکنترلشده استفاده شده است.